Štítek „vytvořeno AI“ nestačí. Tři experimenty ukazují, kdy označení pomáhá a kdy škodí
EU od srpna vyžaduje označovat syntetický obsah. Tři experimenty s více než dvěma tisíci účastníky ukazují, že obecný štítek sdílení dezinformací skoro nebrzdí, nejasný štítek lidi od informací odhání a u vědeckých příspěvků může poškodit hlavně pravdivý obsah.
Foto: Unsplash / Julian
Tento článek vznikl zpracováním veřejně dostupných zdrojů pomocí AI nástrojů. Každý text se snažím přečíst a věcně zkontrolovat, ale ne vždy to zvládnu. Prosím, berte na to ohled a informace si ověřujte v původních zdrojích (níže).
Tento článek vznikl zpracováním veřejně dostupných zdrojů pomocí AI nástrojů. Každý text se snažím přečíst a věcně zkontrolovat, ale ne vždy to zvládnu. Prosím, berte na to ohled a informace si ověřujte v původních zdrojích (níže).
Teze
Od 2. srpna 2026 platí v EU povinnosti podle článku 50 AI Act: poskytovatelé generativních systémů musí výstupy strojově označit a ti, kdo publikují deepfaky nebo některé AI texty o věcech veřejného zájmu, to musí čtenářům sdělit. Firmy se přizpůsobují. Anthropic podle release notes z 3. listopadu rozšířil textový watermark i na starší modely Claude Opus 4.7 a Sonnet 4.6. Regulace i průmysl tak stojí na předpokladu, že když lidé vědí, že obsah vytvořila AI, budou s ním zacházet opatrněji.
Tři experimenty publikované letos s celkem více než dvěma tisíci účastníky tento předpoklad nevyvracejí, ale výrazně ho zužují. Štítek funguje jen v určité podobě. V jiné podobě nedělá nic, odhání lidi od informací, nebo trestá hlavně pravdivý obsah.
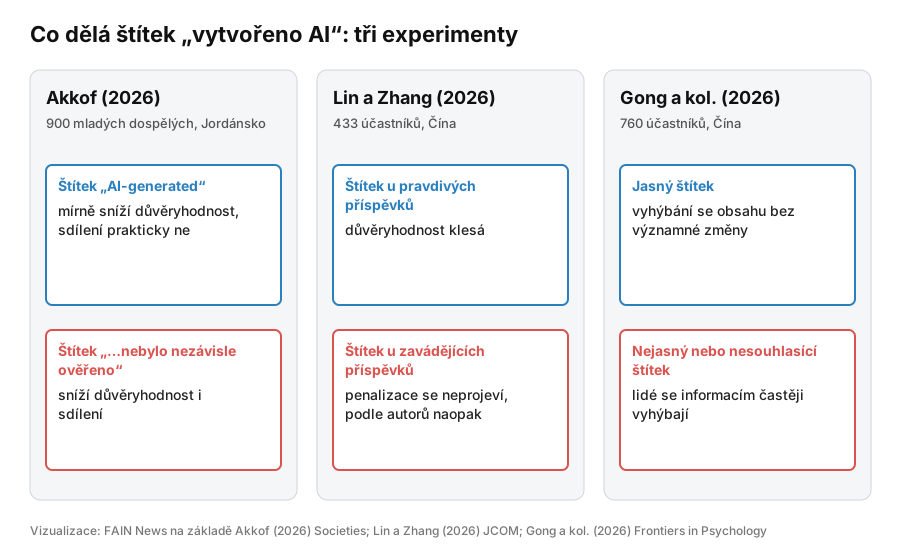 Vizualizace: FAIN News na základě Akkof (2026), Lin a Zhang (2026) a Gong a kol. (2026).
Paper 1: Obecný štítek nesníží sdílení, štítek o ověření ano
✅ Peer-reviewed · Publikováno říjen 2026 · Data sbírána [neuvedeno] · Societies
Alaa Akkof z University of Sharjah nechala 900 mladých dospělých v Jordánsku hodnotit osm arabských příspěvků ze sociálních sítí, pravdivých i nepravdivých, v souladu s jejich názory i proti nim. Účastníci byli náhodně rozděleni do tří skupin: bez štítku, se štítkem „AI-generated“ a se štítkem „AI-generated: tato informace nebyla nezávisle ověřena“.
Obecný štítek snížil důvěryhodnost jen mírně, o 0,08 bodu na sedmibodové škále. Na ochotu sdílet neměl v hlavním modelu statisticky významný vliv. Štítek s upozorněním na chybějící ověření snížil oproti obecnému štítku důvěryhodnost i ochotu sdílet zhruba o 0,2 bodu. Silnější než jakýkoli štítek byl ale vliv názorů: nepravdivé příspěvky, které souhlasily s přesvědčením účastníka, považovali za důvěryhodnější (3,86 oproti 3,31) a ochotněji je sdíleli (3,07 oproti 2,50). Tento efekt oslaboval jen jeden faktor, takzvané actively open-minded thinking.
📚 Heuristicko-systematický model (Chaiken, 1980)
Teorie zpracování přesvědčovacích sdělení. Lidé informace hodnotí buď systematicky, tedy pečlivým zvažováním obsahu, nebo heuristicky, podle rychlých vodítek: kdo to říká, jak to vypadá, jestli to souhlasí s tím, co si myslím. Štítek „vytvořeno AI“ je typická heuristika. Akkof ukazuje, že slabé vodítko nepřebije silnější heuristiku shody s vlastním názorem. Štítek, který explicitně říká „neověřeno“, nutí čtenáře víc přemýšlet.
Paper 2: Štítek trestá pravdu
✅ Peer-reviewed · Publikováno březen 2026 · Data sbírána březen až květen 2024 · Journal of Science Communication
Teng Lin a Yiqing Zhang z University of Chinese Academy of Social Sciences ukázali 433 účastníkům příspěvky ve stylu sítě Weibo o bezpečnosti potravin a prevenci nemocí, napůl správné a napůl zavádějící, vygenerované přes GPT-4. U náhodně vybraných příspěvků se objevil červený štítek „Pozor: obsah byl detekován jako vytvořený AI“.
Výsledek autoři nazývají truth-falsity crossover. U správných informací štítek důvěryhodnost snížil. U zavádějících informací se penalizace neprojevila a podle interpretace autorů štítek jejich důvěryhodnost dokonce zvýšil. Silněji štítek trestal pravdivý obsah u lidí s negativním postojem k AI. V praxi to znamená, že plošný štítek může dopadat hlavně na obsah, který je v pořádku.
📚 Implied truth effect (Pennycook a kol., 2020)
Když platforma označí jen část nepravdivých zpráv varováním, lidé začnou považovat neoznačené zprávy za ověřené, i když ověřené nejsou. Varování tak má vedlejší účinek na všechno, co varování nemá. U štítků AI obsahu hrozí podobná logika: pokud se štítky objevují nekonzistentně, neoznačený obsah může působit jako „lidský, a tedy důvěryhodný“, a označený jako podezřelý bez ohledu na pravdivost.
Paper 3: Nejasný štítek odhání čtenáře
✅ Peer-reviewed · Publikováno březen 2026 · Data sbírána [neuvedeno] · Frontiers in Psychology
Gong a kolegové ve dvou experimentech se 760 účastníky simulovali čínské videoplatformy Bilibili a Douyin. Sledovali, jak štítek ovlivní to, jestli se lidé informacím vyhýbají. Jasný štítek se od žádného štítku nelišil. Nejasný štítek ale vyhýbání výrazně zvýšil (d = 0,57 v první a 0,88 ve druhé studii). Stejně působil štítek, který neodpovídal obsahu. Mechanismem byla kognitivní disonance: rozpor mezi tím, co štítek říká, a tím, co člověk vidí, je nepříjemný a nejjednodušší je obsah přeskočit.
Co z toho vyplývá
Všechny tři studie mluví o štítku určeném lidem, ne o strojovém watermarku. To je důležité rozlišení.
🔍 Watermark vs. štítek pro čtenáře
Watermark je skrytý, strojově čitelný signál vložený do textu, obrázku nebo zvuku. Čtenář ho nevidí, ale detekční nástroj ho pozná. Štítek je viditelné sdělení pro člověka, například „vytvořeno AI“. AI Act vyžaduje obojí, ale od různých aktérů: strojové označení od poskytovatelů modelů, viditelné upozornění od těch, kdo deepfaky nebo některé AI texty publikují. Výzkum o štítcích tedy neříká nic o tom, jestli watermarky fungují technicky. Říká, co se stane, když jejich výsledek ukážeme lidem.
Pro viditelné štítky z experimentů plynou tři poučení. Zaprvé, záleží na znění. Štítek, který říká jen „AI“, říká čtenáři málo, protože AI obsah může být pravdivý i nepravdivý. Štítek, který říká, jestli byl obsah ověřen, dává informaci, se kterou lze něco dělat. Zadruhé, záleží na konzistenci. Nejasné nebo nesouhlasící štítky nepomáhají ani nejsou neutrální: odhánějí lidi od informací. Zatřetí, štítky nepřebijí shodu s vlastním názorem. Mediální gramotnost, která učí rozlišovat „souhlasím“ od „je to pravda“, zůstává nutnou součástí řešení, jak výslovně doporučuje i Akkof.
Evropský kodex pro transparentnost AI obsahu a navazující pokyny Komise mají právě teď prostor tyto poznatky zohlednit. Strojové označování podle článku 50 musí poskytovatelé systémů uvedených na trh před srpnem zavést do 2. prosince 2026. Problém, který jsme popsali u AI reklam v amerických volbách a u streamovacích služeb, se tím ale nevyřeší: technicky správné označení ještě neznamená, že čtenář pochopí, co mu říká.
Výhrady jsou podstatné. Žádná ze studií neproběhla v Evropě, dvě v Číně a jedna v Jordánsku, a kulturní rozdíly v důvěře k AI mohou být velké. Všechny měří deklarované postoje a záměry sdílet, ne skutečné chování na platformách. Data Lin a Zhang pocházejí z jara 2024, tedy zhruba dva roky před publikací, kdy byl AI obsah na sítích méně běžný a štítky novější. U zbylých dvou studií autoři období sběru neuvádějí. Hlavní poselství ale drží napříč zeměmi i designy: otázka „označit, nebo ne“ je špatně položená. Správná otázka zní, co přesně štítek čtenáři říká.
Zdroj obrázku: Unsplash / Julian
Zdroje
- Akkof, A. M. A. (2026). When AI Agrees with Me: Disclosure Labels, Confirmation Bias, and the Sharing of AI-Generated Misinformation Among Jordanian Young Adults. Societies, 16(10), 340.
- Lin, T., & Zhang, Y. (2026). Visible sources and invisible risks: exploring the impact of AI disclosure on perceived credibility of AI-generated content. Journal of Science Communication, 25(1), A09.
- Gong, Z., Peng, D., Cui, J., & Lv, Z. (2026). The paradox of AI content labeling: how clarity influences information avoidance via cognitive dissonance on social platforms. Frontiers in Psychology, 17.
- Pennycook, G., Bear, A., Collins, E. T., & Rand, D. G. (2020). The Implied Truth Effect. Management Science, 66(11).
- Morgan Lewis: EU AI Act's Transparency Rules: What Went Into Effect on 2 August?
- Evropská komise: Code of Practice on transparency of AI-generated content (FAQ)
- Claude Platform: Release notes (watermark, 3. 11. 2026)
- EUR-Lex: Nařízení (EU) 2024/1689 (AI Act)